Реверс-инжиниринг Apple Neural Engine: как вскрыли «чёрный ящик»
Как исследователи вскрыли Apple Neural Engine без документации — от datapath до прямого вызова железа в обход Core ML. Полный разбор.
Введение: самый распространённый AI-ускоритель, о котором никто ничего не знает
Представьте: два с половиной миллиарда устройств по всему миру несут внутри себя специализированный чип для нейронных сетей. Каждый iPhone начиная с X, каждый iPad и каждый Mac на Apple Silicon. И при этом — полный информационный вакуум. Ни публичного ISA, ни документации по архитектуре, ни открытых API для прямого доступа.
Apple Neural Engine — один из наиболее широко развёрнутых ML-ускорителей в мире и при этом один из наименее задокументированных. Apple встроила его в каждый свой SoC начиная с A11 в 2017 году и M1 в 2020-м — то есть почти в каждый проданный с тех пор iPhone, iPad и Mac на Apple Silicon.
Именно этот парадокс заставил группу независимых исследователей взяться за инструменты реверс-инжиниринга. В 2026 году результаты их работы стали достоянием общественности: детальный технический разбор от кремниевого datapath до командного протокола прошивки. Рассмотрим, что внутри, как это удалось вскрыть и почему это важно для всей индустрии edge AI.
Что такое Apple Neural Engine и зачем его скрывать
Apple Neural Engine (ANE) — это специализированный матричный ускоритель с фиксированными функциями, который присутствует в Apple SoC начиная с A11-класса (iPhone/iPad) и M1-класса (Mac) и доступен приложениям исключительно через фреймворк Core ML.
ANE представляет собой fp16-матричный ускоритель с фиксированными функциями и широким аккумулятором. Путь вычислений fp16 и широкий аккумулятор во многом объясняют численное поведение чипа и вносят существенный вклад в его эффективность.
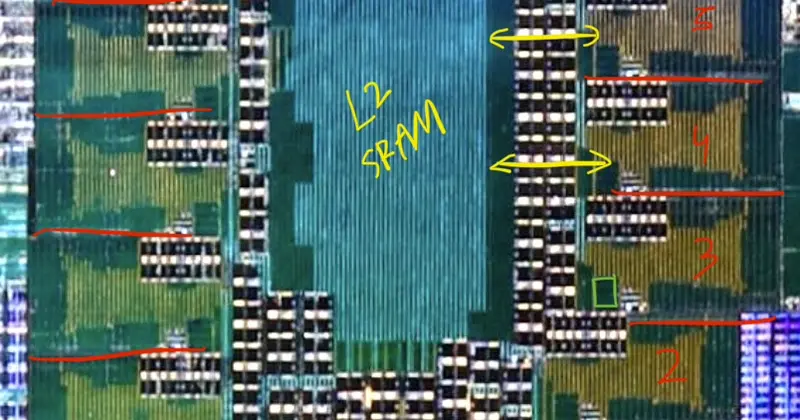
ANE предоставляет управляющую и арифметическую логику, оптимизированную для вычислительно интенсивных операций — умножения и накопления, — широко применяемых в ML- и AI-алгоритмах. Согласно патенту Apple «Multi-Mode Planar Engine for Neural Processor», ANE состоит из нескольких ядер Neural Engine и одной или нескольких многорежимных планарных схем.
Производительность: в чём реальное преимущество
ANE быстрее GPU на compute-bound задачах компьютерного зрения и свёрточных сетей: в 3,8 раза быстрее и в 9 раз эффективнее на свёртке 3×3 с 256 каналами; GPU вырывается вперёд только на bandwidth-bound декодировании.
ANE — это выделенный AI-ускоритель в каждом M-серийном чипе. Он потребляет почти нулевую мощность (около 2 Вт против 20 Вт у GPU) и крайне эффективен на операцию.
Методология: как вскрывали «чёрный ящик»
Исследователи использовали два независимых вектора атаки, которые взаимно верифицировали друг друга.
Этот гайд публикует информацию об ANE, ранее недоступную публично, — достигнутую через набор методов реверс-инжиниринга от кремниевого datapath до системного интерфейса. Использовались два типа свидетельств, подтверждающих друг друга: прямые измерения на Apple Silicon и статическая декомпиляция с динамическим подключением к закрытому рантайму, компилятору, драйверу ядра и прошивке.
graph TD
    A[Прямые измерения на M1/M5] --> C[Перекрёстная верификация]
    B[Статическая декомпиляция\nприватных фреймворков] --> C
    C --> D[Карта datapath и roofline]
    C --> E[Формат программ на диске]
    C --> F[Командный протокол прошивки]
    C --> G[Схема сжатия весов]
    D --> H[Полная документация ANE]
    E --> H
    F --> H
    G --> H
Гайд документирует полный стек ANE через реверс-инжиниринг: аппаратные ограничения пропускной способности, формат программ на диске, сжатие весов, прошивку и прямой путь диспетчеризации в обход Core ML. Охватываются чипы от A11 до A18 и от M1 до M5 — с таблицами данных по каждому чипу и матрицей совместимости операций по устройствам.
Ключевые технические открытия
В числе ключевых технических открытий — MIL (Model Intermediate Language): внутреннее представление ANE в виде типизированного SSA-формата (Static Single Assignment) с дескрипторами тензоров в формате NCDHW. Исследователям пришлось писать MIL-программы напрямую, минуя абстракции CoreML.
Скомпилированные ANE-программы — это структурированные FlatBuffer-бинарники размером 2 680–2 688 байт вне зависимости от размера матрицы, что указывает на параметризованные программы, а не на машинный код под конкретную операцию.
Архитектура изнутри: datapath, память и компилятор
Datapath и roofline
Roofline-модель особенно полезна в данном контексте: она показывает потолок пропускной способности и энергоэффективности с учётом ширины datapath ANE и полосы пропускания памяти. Это позволяет аналитически рассуждать о том, насытит ли данная модель ускоритель или будет страдать от нехватки данных — именно такая информация формирует реальные архитектурные решения при развёртывании инференса на устройстве.
Прямые измерения проводились на M1 и M5, что дало конкретные опорные точки для roofline-модели, описывающей, когда движок ограничен вычислениями, а когда — полосой пропускания памяти.
Сжатие весов и компилятор
ANE — это матричный ускоритель с фиксированными функциями, то есть не универсальный процессор. Он оптимизирован для операций, доминирующих в инференсе нейросетей: прежде всего крупных перемножений матриц и свёрток, — и работает с жёстко сжатыми данными весов для снижения трафика памяти.
Сжатые веса снижают потребность в полосе пропускания между хранилищем весов и вычислительными блоками, не давая массиву умножения-накопления простаивать без данных. Компилятор берёт модель, опускает её в специфичный для ANE формат программ на диске и упаковывает сжатые веса вместе с потоком инструкций. Драйвер ядра затем управляет планировщиком и командным протоколом, подающим работу в прошивку, выполняемую на самом движке.
Прямой доступ: обход Core ML
Движок достижим напрямую, ниже Core ML, из обычного пользовательского процесса. Компилятор ANE опускает граф в собственный формат программ движка, рантайм загружает и диспетчеризирует его без модельного фреймворка, а операции, принимаемые компилятором, не требуют специального разрешения.
Практические выводы: оптимизация под ANE
Реверс-инжиниринг открыл набор конкретных эвристик, которые кардинально влияют на производительность.
Правила максимальной пропускной способности
Одна операция матричного умножения загружает лишь ~30% пиковой мощности ANE. Железо спроектировано для графов — цепочек операций, удерживающих все 16 ядер занятыми. Чем длиннее граф, тем ближе к теоретическому пику.
| Правило | Почему важно |
|---|---|
| Глубокие графы (16–64 операции) | Загружают все ядра, ~30% → ~95% пика |
| Conv 1×1 вместо matmul | matmul в 3 раза медленнее |
| Держать тензоры < 32 МБ | Матричные операции 2048×2048 (24 МБ) дают 5,7 TFLOPS; при 4096×4096 (96 МБ) пропускная способность падает на 30% |
| Избегать динамических форм | ANE требует статических графов |
Представление того же вычисления как свёртки 1×1 вместо перемножения матриц даёт резко более высокую пропускную способность. Матричное умножение C[M,N] = A[M,K] @ B[K,N] можно выразить как свёртку 1×1, переформировав тензоры — те же FLOPs, тот же результат, но datapath для свёртки в ANE обрабатывает это значительно эффективнее.
Пример: прямой вызов ANE на Objective-C
// Упрощённый пример прямого доступа к ANE через приватные API
// (только для исследований — не для продакшна)

#import <Foundation/Foundation.h>
// Приватный фреймворк — не входит в публичный SDK
extern id ANECCompile(NSDictionary *milProgram, NSDictionary *options);
extern void ANECExecute(id compiledProgram, NSDictionary *inputs,
                        NSMutableDictionary *outputs);

// Описание MIL-программы в SSA-формате
NSDictionary *milProgram = @{
    @"version": @"1.0",
    @"operations": @[
        @{@"op": @"conv",
          @"inputs": @{@"x": @"input", @"weight": @"W"},
          @"attrs": @{@"strides": @[@1, @1], @"pad": @"same"}}
    ]
};

id compiled = ANECCompile(milProgram, @{});
NSMutableDictionary *out = [NSMutableDictionary new];
ANECExecute(compiled, @{@"input": myTensor}, out);
Ограничения ANE и его будущее в эпоху LLM
Реверс-инжиниринг обнажил не только возможности ANE, но и его структурные ограничения.
Почему LLM плохо ложатся на ANE
Несмотря на огромную установленную базу, ANE остаётся тёмным ускорителем для больших языковых моделей: ни один публичный фреймворк не поддерживает обучение LLM на ANE, а фреймворки инференса повсеместно нацелены на GPU через Metal или на CPU.
LLM требуют последовательностей переменной длины и авторегрессивной генерации токенов, что плохо сочетается со статической моделью вычислений ANE.
CoreML добавляет 2–4-кратные накладные расходы на мелких операциях по сравнению с прямым доступом к железу. При декодировании токенов LLM, где каждый шаг генерирует единственный токен, эти накладные расходы убивают пропускную способность.
Матрица поддерживаемых операций
| Операция | ANE | CPU |
|---|---|---|
| Свёртка (standard/depthwise) | ✅ | ⚠️ |
| Batched MatMul | ✅ | ⚠️ |
| Активации (ReLU и др.) | ✅ | ⚠️ |
| Element-wise операции | ✅ | ⚠️ |
| Динамические тензоры | ❌ | ⚠️ |
| TopK sampling | ❌ | ⚠️ |
| Scatter/Gather | ❌ | ⚠️ |
| Сравнительные операции | ❌ | ⚠️ |
| LayerNorm | ❌ | ⚠️ |
Источник: данные исследования Orion/maderix, 2026
Историческая роль и переход к GPU
Хотя отдельный Neural Engine обеспечивал эффективное выполнение ранних задач компьютерного зрения и классических ML-фреймворков на мобильных устройствах, его жёсткий datapath и узкие места по памяти в итоге ограничили его адаптивность. Этот комплексный аппаратный аудит подтверждает, что ранние кремниевые допущения Apple, заточенные под свёрточные сети, не смогли масштабироваться до современного авторегрессивного декодирования.
По мере того как компиляторы и GPU-архитектуры эволюционируют для работы с разреженным, весоёмким инференсом трансформеров, специализированный нейропроцессор выполнил свою историческую роль и теперь уступает место более универсальным высокополосным интегрированным решениям.
«Наиболее широко развёрнутый ML-ускоритель в мире — и один из наименее задокументированных» — именно этот парадокс двигал всем исследованием.
Заключение: почему это важно для индустрии
Реверс-инжиниринг ANE — это не просто академическое упражнение. Это прецедент того, как сообщество может восполнять пробелы, которые производители намеренно оставляют закрытыми.
Что открыло исследование:
- Прямой путь к железу — реверс-инженерный командный протокол и формат программ на диске, позволяющие диспетчеризировать матричные операции на движок напрямую, без Core ML.
- Реальные числа производительности — исследователи измерили истинный пиковый перформанс и выяснили, что официальная цифра «38 TOPS» от Apple вводит в заблуждение.
- Полный стек — от кремниевого datapath до системного интерфейса, с данными по чипам от A11 до A18 и M1–M5.
- Путь к обучению — поскольку ANE запекает веса при компиляции, наивное обучение требует полной рекомпиляции на каждом шаге (~4,2 с). Исследователи показали, что вместо этого можно обновлять скомпилированные программы, разгружая, патча файлы весов и перезагружая их — снижая время рекомпиляции с 4200 мс до 494 мс (в 8,5 раза) и ускоряя обучение в 3,8 раза.
Главный урок прост: даже самое закрытое железо, встроенное в 2,5 миллиарда устройств, не может навечно остаться чёрным ящиком. Методичный реверс-инжиниринг, прямые измерения и открытое сообщество рано или поздно снимают любой покров закрытости — и делают технологию доступной для тех, кто в ней действительно нуждается.
Источники
- Apple Neural Engine: Architecture, Programming, and Performance (arxiv)
- Inside the M4 Apple Neural Engine, Part 1: Reverse Engineering
- Orion: Characterizing and Programming Apple's Neural Engine for LLM Training and Inference
- Reverse Engineering Apple's Neural Engine to Train Transformers on M4 (NYU)
- Inside Apple's Neural Engine: A Reverse-Engineered Guide for Embedded AI Builders