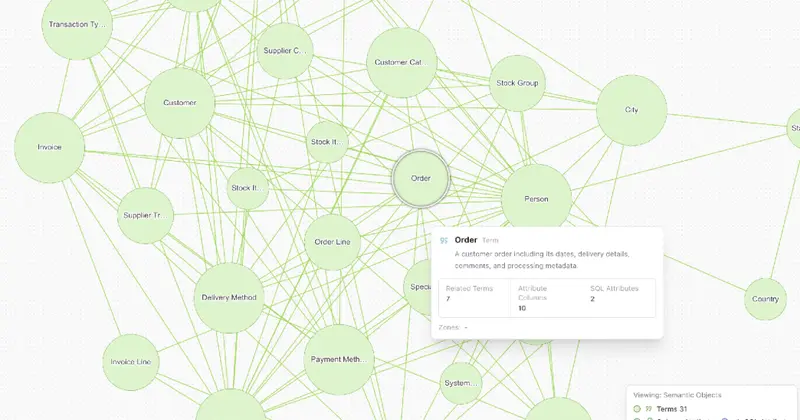
NVIDIA открыла Auto Ontology: семантический слой для AI-агентов
NVIDIA выпустила Auto Ontology — open-source Python-фреймворк для построения семантических графовых слоёв над корпоративными данными. Агенты получают точный контекст для SQL-запросов.
NVIDIA выпустила Auto Ontology — открытый Python-фреймворк, который строит семантический слой над корпоративными данными и позволяет AI-агентам генерировать SQL-запросы детерминированно, с привязкой к бизнес-определениям и провенансом (историей происхождения данных). Проект официально запущен 1 ноября 2026 года и доступен на GitHub под лицензией Apache 2.0.
Зачем это нужно
Агенты умеют делать запросы к базам данных — но надёжность остаётся слабым местом. Один и тот же термин «выручка» в разных системах может означать разные вещи: валовую или чистую, с НДС или без. Auto Ontology строит общий контекст над корпоративными метаданными: сущности и бизнес-метрики, связи между данными, сертифицированные определения и линию данных, провенанс за каждым ответом.
Агент, подключённый через MCP, сначала проверяет отвечаемость вопроса и просит уточнить, если нужного термина нет в онтологии.
Auto Ontology — open-source Python-фреймворк, который строит семантические граф-слои над корпоративными данными, чтобы агенты генерировали SQL детерминированно с провенансом.
Ключевые возможности
Discover — генерация онтологий из метаданных и построение AI-ready knowledge graphs.
Ground — привязка агентов к доверенным бизнес-определениям и согласование несовместимых терминов из разных систем.
Validate — проверка сгенерированных запросов по сертифицированным определениям и линии данных.
Expose — экспозиция контекста через MCP (Model Context Protocol), CLI и API.
Learn — встраивание сертифицированных исправлений обратно в онтологию, улучшение общего контекста с каждым вопросом.
Архитектура системы
graph TD
    A[Корпоративные метаданные] --> B[Слой онтологии / Postgres + pgvector]
    B --> C[Backend FastAPI + LangChain]
    C --> D{Интерфейсы}
    D --> E[MCP — Model Context Protocol]
    D --> F[REST API]
    D --> G[Web UI Next.js]
    C --> H[NVIDIA NIM — Nemotron 3.5 Lightning]
    H --> I[NL-to-SQL / Генерация запросов]
    I --> J[Провенанс + SQL-ответ агенту]
Компоненты стека
| Компонент | Технология | Роль | Порт |
|---|---|---|---|
| Frontend | Next.js 16, React 19, TypeScript, Tailwind CSS 4 | Web UI, аутентификация | 3000 |
| Backend | FastAPI (Python 3.12+), LangChain | Chat, NL-to-SQL, каталог | 3001 |
| Ingestion worker | FastAPI (Python 3.12+) | Загрузка данных и эмбеддингов | 3002 |
| База данных | Postgres + pgvector | Метаданные, онтология, векторное хранилище | 5432 |
| Секреты | HashiCorp Vault (опционально) | Хранение credentials | — |
Модели NVIDIA NIM по умолчанию
Auto Ontology использует NVIDIA NIM (NVIDIA Inference Microservices) — стандартизированные контейнеры для инференса:
- LLM (основная модель):
nvidia/nemotron-3.5-lightning-30b-a3b— открытая MoE-модель с 30B параметрами и 3B активными параметрами, созданная для агентского слоя выполнения. - Эмбеддинги:
nvidia/nemotron-3-embed-1b - Реранкинг:
nvidia/llama-nemotron-rerank-vl-1b-v2
<PREFIX>_ENDPOINT, <PREFIX>_API_KEY, <PREFIX>_MODEL. Если значение не задано — система откатывается к DEFAULT_MODELS. Это позволяет менять только нужные модели, оставив остальные по умолчанию.Пример работы: точный ответ с провенансом
На тестовой базе данных Wide World Importers агент корректно разрешает бизнес-термины в SQL:
-- Вопрос: "Какова была выручка от USB food flash drive - sushi roll
--          в Пенсильвании в июне 2015?"
SELECT SUM(il.extendedprice) AS revenue, COUNT(*) AS invoice_lines
FROM sales.invoicelines il
JOIN sales.invoices i             ON il.invoiceid = i.invoiceid
JOIN warehouse.stockitems si      ON il.stockitemid = si.stockitemid
JOIN sales.customers c            ON i.customerid = c.customerid
JOIN application.cities ct        ON c.deliverycityid = ct.cityid
JOIN application.stateprovinces sp ON ct.stateprovinceid = sp.stateprovinceid
WHERE si.stockitemname = 'USB food flash drive - sushi roll'
  AND sp.stateprovincename = 'Pennsylvania'
  AND i.invoicedate >= '2015-06-01' AND i.invoicedate < '2015-07-01'
-- Ответ: $588.80, из 3 строк накладных
Агент пошагово показывает: какие термины были разрешены, какие JOIN-ы выполнены и как прошла валидация фильтров.
Защита от «неотвечаемых» вопросов
check_answerable → coverage 0.5; no term covers "ad spend" — агент предлагает альтернативу вместо того, чтобы выдать неверный результат.Развёртывание
Открытый релиз включает полный исходный код, документацию по развёртыванию и примеры интеграции. Поддерживаются два варианта:
- Docker Compose — для локального запуска
- Helm chart — для Kubernetes-окружений
Для старта достаточно API-ключа NVIDIA (nvapi-...) с build.nvidia.com и Docker с Compose v2.
Контекст и значение для отрасли
Auto Ontology был анонсирован на конференции GTC Berlin 21 октября 2026 года как open-source библиотека для снижения числа ошибок агентов при работе с корпоративными данными. Инструмент является частью набора компонентов под названием «Agent Knowledge Foundation», который NVIDIA объявила в тот же день.
По состоянию на начало ноября 2026 года NVIDIA ещё не опубликовала числовые показатели точности text-to-SQL для Auto Ontology. Вместо этого компания выпустила отдельный репозиторий auto-ontology-eval с обвязкой для самостоятельного бенчмаркинга на BIRD, BEAVER и других датасетах.
Auto Ontology обеспечивает передачу контекста через несколько интерфейсов, включая Model Context Protocol, CLI и API, что обеспечивает гибкую интеграцию. Проект распространяется под Apache 2.0 и доступен на GitHub: NVIDIA/auto-ontology.