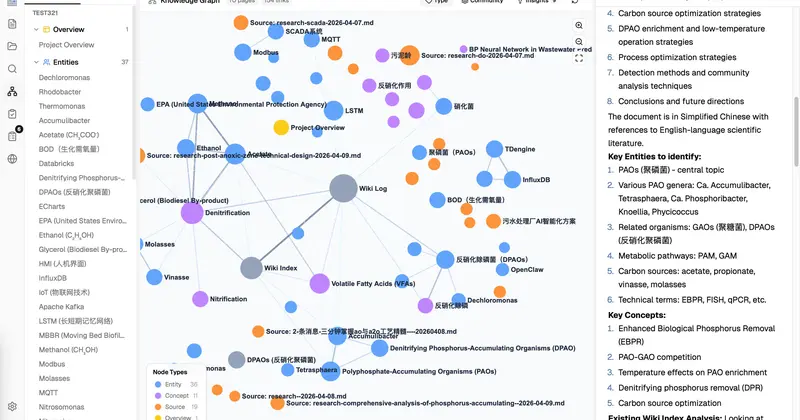
LLM Wiki: база знаний, которая строит себя сама
Обзор LLM Wiki — open-source десктопного приложения, превращающего документы в связанную вики-базу знаний без традиционного RAG.
LLM Wiki: база знаний, которая строит себя сама
«Вместо того чтобы каждый раз заново искать ответы, LLM один раз строит вики — и поддерживает её в актуальном состоянии».
LLM Wiki — кросс-платформенное десктопное приложение, которое автоматически превращает ваши документы в организованную, взаимосвязанную базу знаний. Вместо классического RAG, где знания «переоткрываются» при каждом запросе, LLM инкрементально строит и поддерживает постоянную вики из ваших источников.
Проект основан на концепции LLM Wiki от Андрея Карпатого — методологии построения персональных баз знаний с помощью больших языковых моделей.
Почему не RAG?
Большинство знакомо с RAG: вы загружаете документы, LLM извлекает релевантные фрагменты в момент запроса и генерирует ответ. Это работает, но LLM каждый раз заново «открывает» знания из документов — накопления нет. Задайте тонкий вопрос, требующий синтеза пяти документов, — и модели придётся каждый раз собирать фрагменты заново.
В LLM Wiki знания компилируются один раз и поддерживаются в актуальном состоянии, а не пересчитываются при каждом запросе.
graph TD
    A[📄 Ваши документы\nPDF, EPUB, Office, URL...] --> B[Ingest: двухшаговый\nChain-of-Thought анализ]
    B --> C[Wiki-страницы с\nисточниками и перекрёстными ссылками]
    C --> D[Граф знаний\n4-сигнальная модель релевантности]
    D --> E[Louvain кластеризация\nкластеры тем]
    E --> F[Чат / Поиск / Deep Research]
    F --> G[💡 Накопленный ответ\nбез пересчёта с нуля]
Ключевые возможности
🧠 Двухшаговый Chain-of-Thought Ingest
LLM сначала анализирует исходные документы, выявляя сущности, концепции и связи, а затем генерирует вики-страницы на основе этого анализа. Такой последовательный подход улучшает качество результата по сравнению с одношаговыми методами.
🗂 Мультиформатный парсинг документов
Поддерживается загрузка PDF, Office-документов, EPUB/MOBI, Org mode, изображений, медиафайлов, веб-клипов и пакетных URL с поддержкой встроенного, облачного или локального MinerU для обработки PDF.
🖼 Мультимодальная работа с изображениями
Встроенные изображения извлекаются из PDF, для них генерируются фактические подписи с помощью vision-LLM, и они появляются в результатах поиска с предпросмотром и возможностью перехода к источнику.
🔗 Граф знаний с кластеризацией
Система строит граф знаний по 4-сигнальной модели релевантности (прямые ссылки, перекрытие источников, метрика Adamic-Adar, типовое сходство) и использует алгоритм Louvain для автоматической кластеризации связанных знаний — выявляя неожиданные связи и пробелы.
🔍 Векторный семантический поиск
Опциональный поиск на основе эмбеддингов через LanceDB поддерживает любой OpenAI-совместимый endpoint, расширяя возможности поиска по базе знаний.
🌐 Chrome Web Clipper и HTTP API
В приложении есть Chrome Web Clipper для захвата веб-страниц одним кликом с автозагрузкой в базу знаний, а также локальный HTTP API и MCP-сервер для гибридного поиска, чтения файлов, обхода графа и повторного сканирования источников; готовый агент-скилл устанавливается в Claude Code / Codex одной командой.
🖥 Интерфейс и персистентность
Трёхколоночный макет: дерево знаний / дерево файлов (слева) + чат (центр) + предпросмотр (справа). Панели изменяются перетаскиванием. Панель активности показывает статус обработки файл за файлом в реальном времени. Все состояния (диалоги, настройки, элементы на проверку, конфигурация проекта) сохраняются между перезапусками.
purpose.md и schema.md под конкретную задачу.Технический стек
Приложение построено на Tauri v2, сочетая высокопроизводительный Rust-бэкенд с React 19 фронтендом.
Frontend: React 19, Tailwind CSS 4, Zustand (состояние), Milkdown (редактор), Sigma.js (граф). Backend: Rust (Tauri), LanceDB (векторное хранилище), pdfium-render (обработка PDF), tokio (async runtime).
Установка из исходников
Для сборки требуются Node.js 20+ и Rust 1.70+.
git clone https://github.com/nashsu/llm_wiki.git
cd llm_wiki
npm install
npm run tauri dev    # Режим разработки
npm run tauri build  # Продакшн-сборка
Для большинства пользователей проще скачать готовые бинарники со страницы Releases (macOS .dmg, Windows .msi, Linux .deb/.AppImage).
Для работы необходима настройка LLM-провайдера (OpenAI, Anthropic, Google, Ollama, Custom) с API-ключами.
Поддерживаемые LLM-провайдеры
Приложение поддерживает OpenAI, Anthropic, Google, Ollama и кастомные провайдеры — каждый со своим стримингом и заголовками. Настройки провайдера, API-ключа, модели, размера контекста и языка сохраняются через Tauri Store.
Цены и лицензия
Проект распространяется под лицензией GNU GPL v3.0. Само приложение полностью бесплатно. Функциональность зависит от внешних LLM API, которые могут нести затраты и добавлять задержку.
| Составляющая | Стоимость |
|---|---|
| Приложение LLM Wiki | Бесплатно (open-source) |
| Ollama (локальные модели) | Бесплатно |
| OpenAI / Anthropic / Google | Pay-per-token |
| Chrome Extension | Бесплатно |
| MCP-сервер | Бесплатно |
Плюсы и минусы
| ✅ Плюсы | ❌ Минусы |
|---|---|
| Накопительная база знаний вместо «одноразового RAG» | Требует настройки LLM-провайдера (не «из коробки» без API-ключа) |
| Полностью локальный вариант через Ollama | Качество вики напрямую зависит от качества выбранной модели |
| Мультиплатформенность (Windows, macOS, Linux) | Инкрементальный ingest может быть медленным для большого корпуса |
| Поддержка PDF, Office, EPUB, URL, веб-клипов | GPL v3 — ограничения для коммерческого встраивания |
| Граф знаний с кластеризацией Louvain | Интерфейс только на English и Chinese (нет русского) |
| MCP-сервер и HTTP API для интеграции с агентами | Ранняя стадия (v0.6.x) — возможны баги |
| Открытый исходный код, активное развитие | Нет встроенного облачного хранилища / синхронизации |
Сравнение с альтернативами
Среди платных альтернатив — Google NotebookLM (бесплатный, но ограниченный и только облако), Notion AI ($10/пользователь/мес), Mem.ai ($15–25/мес), Roam Research ($15/мес).
| Параметр | LLM Wiki | Google NotebookLM | Notion AI |
|---|---|---|---|
| Модель работы с данными | Накопительная вики | Одноразовый RAG | Одноразовый RAG |
| Цена | Бесплатно (BYOLLM) | Бесплатно / лимиты | $10+/мес |
| Локальный режим | ✅ (Ollama) | ❌ | ❌ |
| Граф знаний | ✅ | ❌ | ❌ |
| Форматы файлов | PDF, Office, EPUB, URL и др. | PDF, Google Docs, аудио | Notion-страницы |
| MCP / API | ✅ | ❌ | Ограниченно |
| Open Source | ✅ GPL v3 | ❌ | ❌ |
| Платформы | Win / macOS / Linux | Браузер | Браузер + приложение |
| Мультимодальность | ✅ (vision LLM для изображений) | ✅ | ❌ |
Вердикт
LLM Wiki — одна из самых концептуально интересных open-source разработок в нише knowledge management 2026 года. Идея не просто «спрашивать у документов», а строить из них живую, самообновляющуюся вики — принципиально отличает инструмент от всех RAG-чат-систем.
Вместо того чтобы воспринимать ИИ как поисковик, LLM Wiki предлагает относиться к нему как к библиотекарю, который по-настоящему поддерживает библиотеку: каждый новый документ читается, анализируется, перекрёстно ссылается на всё остальное и помещается в постоянную взаимосвязанную базу знаний.
Кому идеально подойдёт:
- Исследователям и академикам с большим корпусом литературы
- Аналитикам, которые работают с разнородными источниками
- Разработчикам, строящим AI-агентов (MCP / API из коробки)
- Энтузиастам PKM (Personal Knowledge Management), ищущим альтернативу Obsidian + плагины
Кому пока не подойдёт:
- Тем, кто хочет решение «без настройки» и без API-ключей
- Командам, которым нужна облачная синхронизация и совместная работа
Рейтинг: 8.5 / 10
| Критерий | Оценка |
|---|---|
| Концепция и оригинальность | ⭐⭐⭐⭐⭐ |
| Функциональность | ⭐⭐⭐⭐½ |
| Простота настройки | ⭐⭐⭐ |
| Зрелость / стабильность | ⭐⭐⭐½ |
| Экосистема и интеграции | ⭐⭐⭐⭐ |